o que construí
Construí o bend-ml para levar machine learning em Bend além de um exemplo pequeno: tensores, um tokenizer, diferenciação automática e modelos que rodam de verdade. Os cinco pacotes estão publicados no BendHub.
Uma matriz carrega suas dimensões no tipo. Se duas matrizes não podem ser multiplicadas, o programa é rejeitado antes de executar esse produto. A mesma ideia vale para dimensões que só são conhecidas em tempo de execução.
um exemplo concreto
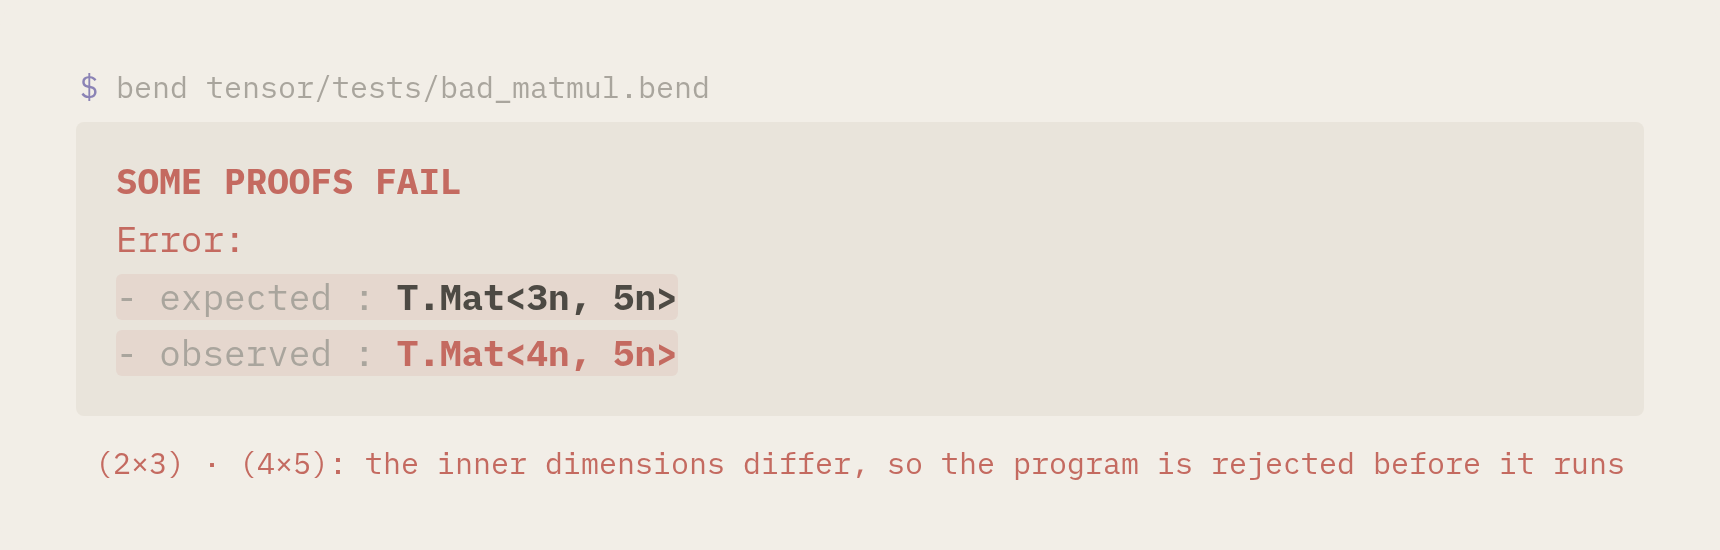
Multiplicar uma matriz 2 × 3 por uma 4 × 5 exigiria que as dimensões internas fossem iguais. Aqui elas não são: o Bend espera três linhas na segunda matriz e encontra quatro.
um erro detectado pelos tipos
2 × 34 × 5SOME PROOFS FAIL
expected  Mat<3n, 5n>
observed  Mat<4n, 5n>
As dimensões incompatíveis do exemplo público, desenhadas aqui. A saída original do checador está nos links abaixo.
fonte pública ↗abrir imagem completa ↗
as decisões
- Manter o shape no tipo, inclusive com tamanhos simbólicos. Um reshape exige uma prova de que preserva a quantidade de elementos.
- Publicar pacotes separados para lemas aritméticos, tokenização BPE, tensores em listas, tensores em arrays e diferenciação automática.
- Guardar as linhas das matrizes em bandas para o trabalho paralelo. Cada tarefa recebe sua parte dos pesos em vez de uma cópia da matriz inteira.
os resultados
- A demo de MNIST treina um classificador de dígitos. Com os mesmos pesos iniciais e batches, a perda e os acertos correspondem à referência em PyTorch.
- O GPT-2 small gera os mesmos tokens em decodificação greedy que o PyTorch nos 11 prompts testados; o erro reportado nos logits fica dentro de 3.2e-4. O tokenizer corresponde ao tiktoken em 79 textos.
- As leis dos pacotes são checadas novamente pelo kernel do Bend, provado em Lean. Elas cobrem propriedades estruturais, como o roundtrip do tokenizer e a concordância entre diferenciação reversa e direta.
as limitações
- Os resultados numéricos são testados contra PyTorch, NumPy e tiktoken. A aritmética de ponto flutuante não é provada equivalente à aritmética real.
- As comparações públicas incluem as perdas: o GPT-2 é mais lento que PyTorch e llama.cpp nas execuções de CPU reportadas, e o MNIST é mais lento apesar de usar menos memória. O README reúne as figuras e o contexto das versões.
- As demos mostram o que os pacotes fazem; elas não estabelecem prontidão para produção ou desempenho em outras máquinas.
README de referência ↗ · comparações publicadas ↗