construído sobre bend-ml.
o que construí
Construí o llama.bend sobre o bend-ml para rodar modelos de linguagem da arquitetura Llama em Bend. Um pacote executa SmolLM2-135M, SmolLM2-360M e SmolLM2-1.7B na CPU; só a configuração muda.
O pacote está publicado no BendHub como bend-ml-llama. Cada matriz de pesos recebe seu shape da configuração do modelo, e o cache de chaves e valores carrega tanto a capacidade quanto a quantidade de posições já escritas.
um exemplo concreto
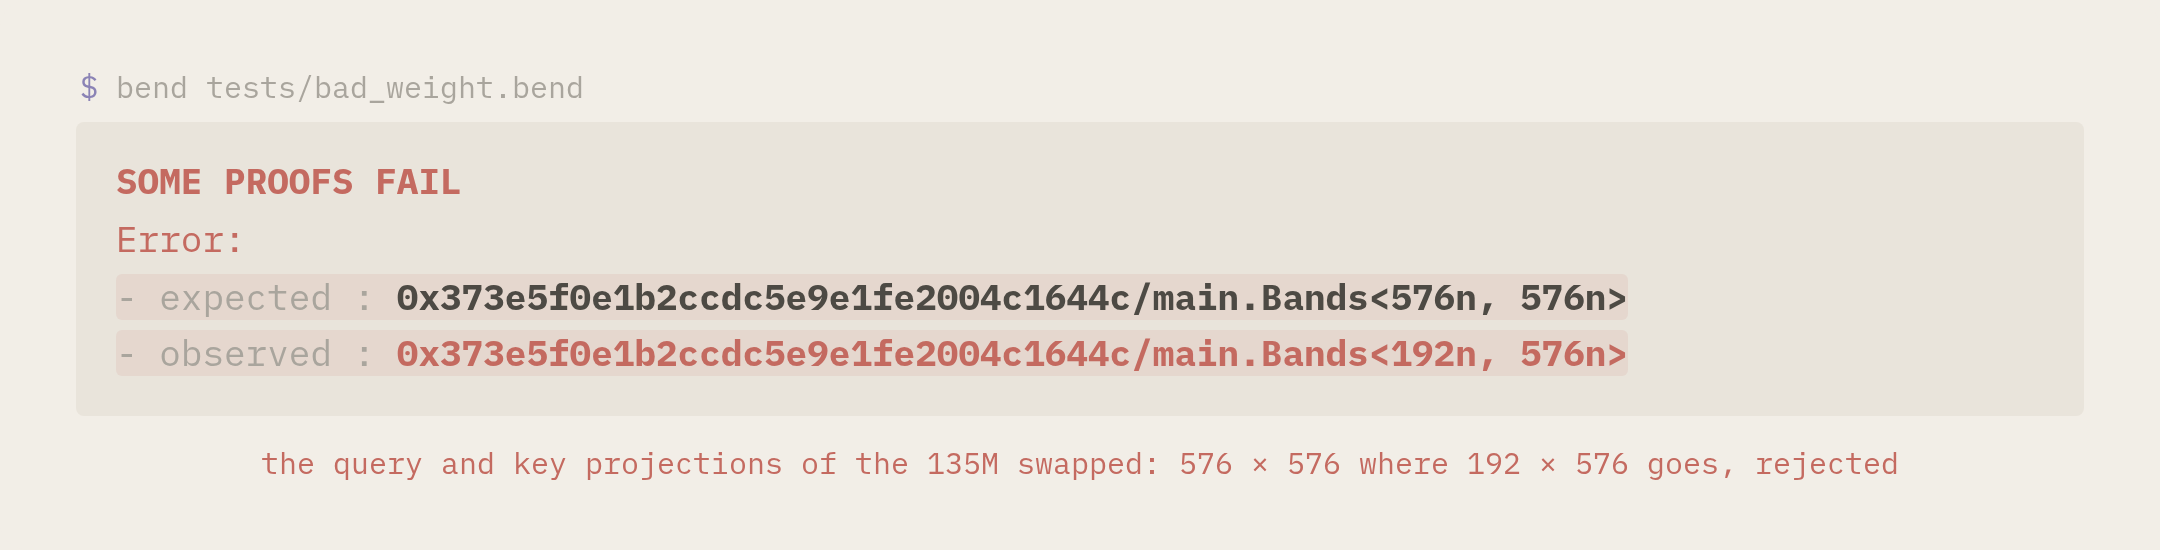
No SmolLM2-135M, a projeção de queries é 576 × 576 e a de keys é 192 × 576. Trocar uma pela outra é um erro que os tipos rejeitam antes de executar o modelo.
um erro detectado pelos tipos
576 × 576192 × 576SOME PROOFS FAIL
expected  Bands<576n, 576n>
observed  Bands<192n, 576n>
Os shapes de queries e keys do SmolLM2-135M. Trocar os pesos é rejeitado; a saída original do checador está nos links abaixo.
fonte pública ↗abrir imagem completa ↗
as decisões
- Derivar os shapes dos pesos de uma configuração, para que as mesmas camadas tipadas atendam aos três tamanhos de modelo.
- Checar leis estruturais para o mapeamento entre cabeças de atenção, as leituras causais do cache, sua capacidade, a divisão das cabeças no RoPE e o layout dos pesos.
- Escrever o tokenizer também em Bend e compará-lo de forma independente com a referência. As provas são apagadas durante a compilação.
os resultados
- Para cada um dos três modelos, os 32 tokens gerados em decodificação greedy e o texto decodificado correspondem ao transformers nos 12 prompts testados, usando transformers 5.19 em F32 com atenção eager.
- Verificações separadas comparam logits em 11 prompts e o token de maior pontuação em 88 posições. Tokens gerados iguais não significam que todos os valores de ponto flutuante sejam idênticos.
- O tokenizer corresponde aos ids da referência em 68 textos fixos e 600 aleatórios; a decodificação é comparada em 1.500 sequências aleatórias de tokens.
as limitações
- Somente CPU, modelos base e decodificação greedy, sem template de chat. Os vetores entre camadas são listas cujos comprimentos não estão nos tipos.
- Na comparação publicada em 2026-10-13, o SmolLM2-1.7B fica 3,7–4,9 vezes mais lento que o llama.cpp. O carregamento é a parte mais demorada. O BENCHMARK.md registra hardware, versões e medições; esses resultados não são previsões para outras máquinas.
- As leis estabelecem garantias estruturais. A precisão numérica e o texto gerado são testados contra referências, não provados formalmente.
README de referência ↗ · comparações publicadas ↗